
Algoritam najbližeg suseda (k-NN) od nule
Kako bi ti pogodio vrstu nepoznatog ploda? Verovatno bi ga uporedio sa plodovima koje poznaješ i rekao: „najviše liči na jabuke“. Na toj ideji radi algoritam k najbližih suseda (engl. k-nearest neighbors, k-NN). Napisaćemo ga sami, samo sa listama i petljama.
Ideja algoritma
- Svaki plod je tačka na grafiku (x = masa, y = dužina).
- Za novi plod izračunamo rastojanje do svakog poznatog ploda.
- Uzmemo k najbližih (npr. k = 3).
- Oni „glasaju“: vrsta koju ima većina je naš odgovor.
Rastojanje između tačaka (x₁, y₁) i (x₂, y₂) računamo po Pitagorinoj teoremi: √((x₁ − x₂)² + (y₁ − y₂)²).
Važan korak: skaliranje
Masa je u stotinama grama (115–250), a dužina u centimetrima (7–21). Razlika od 30 g bi u rastojanju „vredela“ mnogo više od razlike od 10 cm – iako je 10 cm ogromna razlika za voće. Zato obe osobine prevedemo u opseg od 0 do 1:
nova vrednost = (vrednost − najmanja) / (najveća − najmanja)
Tako su obe osobine podjednako važne. Šta se desi bez skaliranja, videćeš u prvom zadatku.
Program
# Algoritam k najbližih suseda (k-NN) – bez biblioteka, samo liste i petlje
import csv
import math
import random

# 1) učitavanje podataka
podaci = []
with open("voce.csv", encoding="utf-8") as f:
    for red in csv.DictReader(f):
        podaci.append((float(red["masa"]), float(red["duzina"]), red["vrsta"]))

# 2) skaliranje: masa (100–250) i dužina (7–21) imaju različite opsege,
#    pa obe osobine prevodimo u opseg 0..1 da bi bile podjednako važne
min_m = min(p[0] for p in podaci); max_m = max(p[0] for p in podaci)
min_d = min(p[1] for p in podaci); max_d = max(p[1] for p in podaci)


def skaliraj(masa, duzina):
    return ((masa - min_m) / (max_m - min_m), (duzina - min_d) / (max_d - min_d))


primeri = [(skaliraj(m, d), v) for m, d, v in podaci]

# 3) podela na učenje (80 %) i proveru (20 %)
random.seed(1)                       # isti „slučajni“ raspored pri svakom pokretanju
random.shuffle(primeri)
granica = int(len(primeri) * 0.8)
ucenje, provera = primeri[:granica], primeri[granica:]


def rastojanje(a, b):
    """Obično (euklidsko) rastojanje između dve tačke."""
    return math.sqrt((a[0] - b[0]) ** 2 + (a[1] - b[1]) ** 2)


def knn(tacka, k):
    """Vrati vrstu koju ima većina od k najbližih primera za učenje."""
    sortirano = sorted(ucenje, key=lambda p: rastojanje(tacka, p[0]))
    glasovi = {}
    for _, vrsta in sortirano[:k]:
        glasovi[vrsta] = glasovi.get(vrsta, 0) + 1
    return max(glasovi, key=glasovi.get)


# 4) provera tačnosti za nekoliko vrednosti k
for k in [1, 3, 5]:
    tacno = sum(1 for tacka, vrsta in provera if knn(tacka, k) == vrsta)
    print(f"k = {k}: {tacno} od {len(provera)} tačno ({tacno / len(provera) * 100:.0f} %)")

# 5) novi plod
nov = skaliraj(200, 8.3)
print("Plod od 200 g i 8,3 cm je:", knn(nov, 3))
Ispis programa:
k = 1: 5 od 6 tačno (83 %)
k = 3: 5 od 6 tačno (83 %)
k = 5: 5 od 6 tačno (83 %)
Plod od 200 g i 8,3 cm je: pomorandza
random.seed(1)čini da „slučajno“ mešanje bude isto pri svakom pokretanju – tako možemo da poredimo rezultate.sorted(..., key=lambda p: rastojanje(tacka, p[0]))ređa primere od najbližeg do najdaljeg.- Rečnik
glasovibroji glasove;max(glasovi, key=glasovi.get)vraća vrstu sa najviše glasova. - Na 6 primera za proveru model greši jednom – to je jabuka koja je veoma blizu pomorandžama.
Bonus: mapa odluka
Ako k-NN pitamo za svaku tačku ravni, dobijamo mapu: koja vrsta bi bila na kom mestu. Granice između boja su granice koje je model „naučio“.
# Bonus: „mapa odluka“ – za svaku tačku ravni k-NN kaže koja bi to vrsta bila
import csv
import math
import matplotlib.pyplot as plt

podaci = []
with open("voce.csv", encoding="utf-8") as f:
    for red in csv.DictReader(f):
        podaci.append((float(red["masa"]), float(red["duzina"]), red["vrsta"]))

min_m = min(p[0] for p in podaci); max_m = max(p[0] for p in podaci)
min_d = min(p[1] for p in podaci); max_d = max(p[1] for p in podaci)


def skaliraj(masa, duzina):
    return ((masa - min_m) / (max_m - min_m), (duzina - min_d) / (max_d - min_d))


primeri = [(skaliraj(m, d), v) for m, d, v in podaci]


def knn(tacka, k=3):
    sortirano = sorted(primeri, key=lambda p: math.dist(tacka, p[0]))
    glasovi = {}
    for _, vrsta in sortirano[:k]:
        glasovi[vrsta] = glasovi.get(vrsta, 0) + 1
    return max(glasovi, key=glasovi.get)


boje = {"jabuka": "red", "banana": "gold", "pomorandza": "darkorange"}
# mreža tačaka: masa od 100 do 260 g, dužina od 6 do 22 cm
for masa in range(100, 261, 4):
    for d10 in range(60, 221, 4):
        duzina = d10 / 10
        plt.scatter(masa, duzina, c=boje[knn(skaliraj(masa, duzina))], s=12, alpha=0.25, marker="s")

for vrsta in boje:          # pravi primeri preko mape
    plt.scatter([m for m, d, v in podaci if v == vrsta], [d for m, d, v in podaci if v == vrsta],
                c=boje[vrsta], edgecolors="black", label=vrsta)
plt.xlabel("masa (g)")
plt.ylabel("dužina (cm)")
plt.title("k-NN (k = 3): koja vrsta bi bila na svakom mestu")
plt.legend()
plt.show()
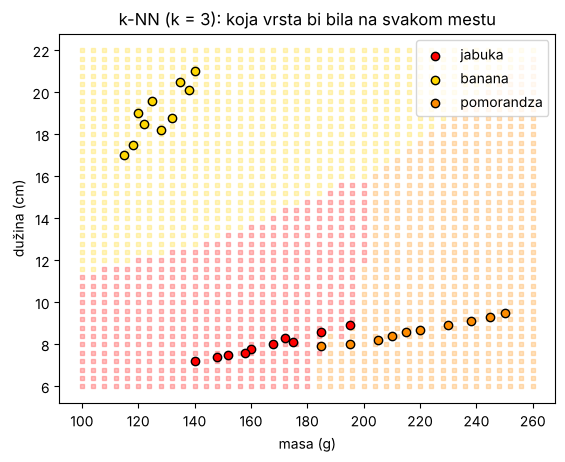
k-NN nema „trening“ u pravom smislu – on samo pamti sve primere. Zato je jednostavan, ali je spor kada primera ima milion: za svaki novi plod mora da izračuna milion rastojanja.
Prvo „ručni k-NN“: na odštampanom grafiku učenici crtaju novi plod i šestarom traže 3 najbliže tačke. Zatim pišu program i proveraju svoje odgovore.
Česte zablude
- „k-NN „razume“ voće“ – on samo meri rastojanja do poznatih primera.
- „Veće k je uvek bolje“ – preveliko k pita i daleke primere; kada je k jednak broju svih primera, odgovor je uvek vrsta kojih ima najviše.
Zadaci za vežbu
Pokušaj prvo sam, pa tek onda otvori rešenje.
- Izbaci skaliranje (koristi masu i dužinu kakve jesu) i proveri šta k-NN kaže za malu jabuku od 130 g i 8 cm.
- Napiši program koji odjednom razvrstava listu novih plodova: (150 g, 7,6 cm), (128 g, 18 cm), (240 g, 9,2 cm), (190 g, 8,3 cm).
- Šta bi k-NN odgovorio za bilo koji plod kada bi k bio jednak broju svih primera za učenje (24)? Zašto?
Rešenje 1: bez skaliranja
# Zadatak: k-NN BEZ skaliranja – masa „preglasa“ dužinu
import csv, math, random

podaci = []
with open("voce.csv", encoding="utf-8") as f:
    for red in csv.DictReader(f):
        podaci.append(((float(red["masa"]), float(red["duzina"])), red["vrsta"]))

random.seed(1)
random.shuffle(podaci)
ucenje, provera = podaci[:24], podaci[24:]


def knn(tacka, k):
    sortirano = sorted(ucenje, key=lambda p: math.dist(tacka, p[0]))
    glasovi = {}
    for _, v in sortirano[:k]:
        glasovi[v] = glasovi.get(v, 0) + 1
    return max(glasovi, key=glasovi.get)


tacno = sum(1 for t, v in provera if knn(t, 3) == v)
print(f"Bez skaliranja: {tacno} od {len(provera)} tačno")
# Plod od 130 g i 8 cm (mala jabuka) – šta kaže model bez skaliranja?
print("130 g, 8 cm ->", knn((130, 8), 3))
Ispis programa:
Bez skaliranja: 5 od 6 tačno
130 g, 8 cm -> banana
Bez skaliranja mala jabuka postaje „banana“: po masi (130 g) je najbliža bananama, a razlika u dužini (8 cm prema 18 cm) skoro da se ne računa. Sa skaliranjem odgovor je ispravan – jabuka.
Rešenje 2: više plodova
# Zadatak: razvrstaj više novih plodova odjednom (k-NN sa skaliranjem, k = 3)
import csv, math

podaci = []
with open("voce.csv", encoding="utf-8") as f:
    for red in csv.DictReader(f):
        podaci.append((float(red["masa"]), float(red["duzina"]), red["vrsta"]))
min_m = min(p[0] for p in podaci); max_m = max(p[0] for p in podaci)
min_d = min(p[1] for p in podaci); max_d = max(p[1] for p in podaci)


def skaliraj(m, d):
    return ((m - min_m) / (max_m - min_m), (d - min_d) / (max_d - min_d))


primeri = [(skaliraj(m, d), v) for m, d, v in podaci]


def knn(tacka, k=3):
    sortirano = sorted(primeri, key=lambda p: math.dist(tacka, p[0]))
    glasovi = {}
    for _, v in sortirano[:k]:
        glasovi[v] = glasovi.get(v, 0) + 1
    return max(glasovi, key=glasovi.get)


novi = [(150, 7.6), (128, 18.0), (240, 9.2), (190, 8.3)]
for m, d in novi:
    print(f"{m} g, {d} cm -> {knn(skaliraj(m, d))}")
Ispis programa:
150 g, 7.6 cm -> jabuka
128 g, 18.0 cm -> banana
240 g, 9.2 cm -> pomorandza
190 g, 8.3 cm -> pomorandza
Rešenje 3: objašnjenje
Uvek isto – vrstu koje ima najviše među 24 primera za učenje, jer bi glasali svi primeri bez obzira na rastojanje. Zato k mora da bude malo u odnosu na broj primera (često 3, 5 ili 7, neparno da ne bude nerešeno).
Proveri znanje
Otvori kviz
Kviz: k najbližih suseda
1. Kako k-NN odlučuje?
2. Zašto se osobine skaliraju na opseg 0..1?
3. Šta radi random.seed(1)?
4. Koja je mana k-NN kada ima mnogo primera?